AI aģenti nelasa JavaScript - kā pārbaudīt, vai jūsu mājaslapa ir redzama AI meklētājiem
Svarīgi: ne visi AI aģenti un crawleri darbojas vienādi. Googlebot un browser tipa aģenti var izpildīt JavaScript, bet vairāki nozīmīgi AI crawleri publiskos testos to nav darījuši.
Tāpēc šī raksta virsraksts ir apzināti ass, bet pats jautājums ir niansētāks.
Pareizais jautājums nav:
"Vai AI lasa JavaScript?"
bet:
"Vai mūsu svarīgākais saturs ir pieejams arī sistēmai, kas saņem tikai sākotnējo HTML un JavaScript neizpilda?"
Tieši šis jautājums radās arī mūsu pašu Brandsite SEO auditā.
2026. gada 25. oktobrī veicām Brandsite mājaslapas SEO auditu, izmantojot Ahrefs Site Audit un papildu manuālu analīzi.
Viens no virzieniem, kuru audits lika pārbaudīt padziļināti, bija satura pieejamība un JavaScript loma dažādu robotu skatījumā.
Mēs sākām salīdzināt:
ko pārlūkā redz cilvēks
pret
ko serveris nosūta sākotnējā HTML pirms JavaScript izpildes.
Tas nebija secinājums, ka "Brandsite neredz AI" vai ka JavaScript pats par sevi ir problēma.
Tas radīja daudz vērtīgāku tehnisku jautājumu:
vai būtiskā informācija, ko vēlamies padarīt atrodamu Google un AI meklēšanā, ir pieejama arī tad, ja konkrētais robots lapu nerenderē kā pilnvērtīgs pārlūks?
Šajā rakstā parādīsim, kā šo risku pārbaudīt pašiem, kā interpretēt rezultātu un ko darīt, ja svarīgs saturs kļūst pieejams tikai pēc JavaScript izpildes.
~ 16min
07/11/2026
Kāpēc šis jautājums kļuvis svarīgs AI meklēšanas laikā?
Tradicionālajā SEO galvenais tehniskais jautājums ilgu laiku bija:
"Vai Googlebot var šo lapu pārmeklēt, renderēt un indeksēt?"
Google JavaScript apstrādā jau gadiem.
Taču AI meklēšanas vide nav viens robots un nav viena tehnoloģija.
Šodien uzņēmuma saturam var piekļūt:
- Googlebot;
- AI Search crawleri;
- modeļu apmācības crawleri;
- lietotāja iniciēti fetcheri;
- browser aģenti;
- citi automatizēti roboti.
Tie var izmantot atšķirīgu infrastruktūru un tiem var būt atšķirīgi mērķi.
Tāpēc:
"AI bots" nav viena tehniska kategorija.
Ko publiskie testi rāda par AI crawleriem un JavaScript?
Te svarīgs ir datums.
Vercel un MERJ 2024. gada 17. decembrī publicētajā analīzē vairāki lielie AI crawleri JavaScript neizpildīja.
Testētajā periodā tas attiecās uz:
- OpenAI OAI-SearchBot;
- GPTBot;
- ChatGPT-User;
- Anthropic ClaudeBot;
- Meta-ExternalAgent;
- ByteDance Bytespider;
- PerplexityBot.
Savukārt Google infrastruktūra JavaScript renderēja.
Vercel/MERJ novēroja arī interesantu niansi: daži crawleri JavaScript failus pieprasīja, taču tas nenozīmēja, ka tie šo kodu izpildīja un izveidoja tādu pašu lapas stāvokli kā pārlūkprogramma.
Šie rezultāti raksturoja crawleru uzvedību konkrētajā 2024. gada testēšanas periodā.
AI platformu infrastruktūra mainās, tāpēc tos nevajadzētu interpretēt kā garantiju, ka katrs serviss 2026. gada novembrī vienmēr uzvedas identiski.
Tomēr Vercel arī jaunākos materiālos joprojām atsaucas uz šo novērojumu, īpaši brīdinot par produktiem un citu informāciju, kas tiek ielādēta tikai pēc klienta puses JavaScript izpildes.
Tāpēc drošākais tehniskais princips paliek vienkāršs:
svarīgākajam publiskajam saturam nevajadzētu būt pieejamam tikai pēc client-side JavaScript izpildes.
Kas ir sākotnējais HTML?
Kad cilvēks atver mājaslapu, pārlūkprogramma vispirms saņem servera atbildi.
HTML dokumentā var jau būt:
- H1;
- teksti;
- saites;
- navigācija;
- produktu informācija;
- cenas;
- meta dati.
Pēc tam pārlūkprogramma var izpildīt JavaScript, kas:
- pievieno papildu saturu;
- ielādē datus no API;
- maina lapas elementus;
- aktivizē interaktīvas funkcijas;
- izveido klienta puses komponentus.
Risks rodas situācijā, kur sākotnējais HTML satur tikai minimālu aplikācijas karkasu, piemēram:
<div id="app"></div>
bet būtiskais saturs tiek izveidots tikai pēc JavaScript izpildes.
Cilvēks pārlūkā redz pilnvērtīgu lapu.
Crawleris, kas JavaScript neizpilda, var saņemt daudz mazāk informācijas.
Vienkāršs tests, ko varat veikt paši dažu minūšu laikā
Šī nav pilnvērtīga AI redzamības pārbaude, bet tā ir ļoti laba pirmā diagnostika.
1. Izvēlieties svarīgu lapu
Piemēram:
- pakalpojuma lapu;
- produkta lapu;
- kategoriju;
- svarīgu bloga rakstu;
- "Par mums" lapu.
Nevajag pārbaudīt tikai sākumlapu.
Izvēlieties lapas, kuru informācijai tiešām jābūt atrodamai.
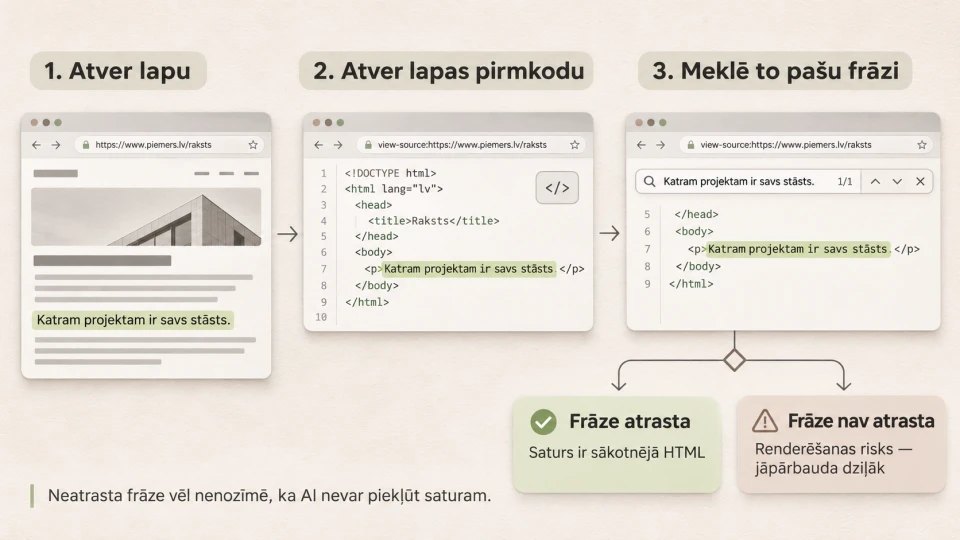
2. Atrodiet unikālu teikumu
Atveriet lapu parastā pārlūkprogrammā un nokopējiet vienu svarīgu teikumu no galvenā satura.
Piemēram:
"Izstrādājam individuālas web aplikācijas ar lietotāju lomām, datu plūsmām un API integrācijām."
Izvēlieties kaut ko specifisku, nevis navigācijas tekstu.
3. Desktop pārlūkā atveriet View Source
Chrome un vairākās citās desktop pārlūkprogrammās var izmantot:
view-source:https://jusudomens.lv/lapa/
vai izvēlēties:
View Page Source / Skatīt lapas pirmkodu
View Source mobilajās ierīcēs nav tik universāli pieejams, tāpēc šo pārbaudi vienkāršāk veikt datorā.
4. Meklējiet to pašu frāzi
Izmantojiet:
Ctrl + F
vai Mac:
Cmd + F
un ievadiet izvēlēto teikumu.
5. Interpretējiet rezultātu
Ja teksts ir sākotnējā HTML:
tas ir labs sākuma signāls. Būtiskais saturs nav pilnībā atkarīgs no client-side JavaScript.
Ja teksts nav sākotnējā HTML, bet pārlūkā ir redzams:
saturs, iespējams, tiek pievienots renderēšanas laikā.
Tas nenozīmē:
"AI šo lapu neredz."
Tas nozīmē:
"Šim saturam ir atkarība no renderēšanas, kuru vajadzētu pārbaudīt padziļināti."
Tas ir riska indikators, nevis diagnoze.
Otrais tests: kas notiek bez JavaScript?
Nākamais jautājums:
vai lapa joprojām sniedz jēgpilnu informāciju, ja JavaScript neizpildās?
Nav nepieciešams, lai bez JavaScript darbotos pilnīgi viss.
Piemēram, nav kritiski, ja nedarbojas:
- animācija;
- live chat;
- sarežģīts filtrs;
- kalkulators;
- karuselis;
- lietotāja paneļa interaktīvas funkcijas.
Taču publiski svarīgā lapā nevajadzētu pazust:
- H1;
- galvenajam pakalpojuma vai produkta aprakstam;
- būtiskām specifikācijām;
- galvenajiem ieguvumiem;
- svarīgām iekšējām saitēm;
- uzņēmuma pieredzes informācijai.
Interaktivitāte var būt JavaScript. Informācijas eksistencei nav obligāti jābūt atkarīgai no JavaScript.
Tas ir viens no svarīgākajiem principiem visā šajā rakstā.
Trešais tests: pārbaudiet robots.txt
Dažreiz problēmai nav nekāda sakara ar renderēšanu.
Saturs HTML var būt perfekti pieejams, bet crawlerim piekļuve ir aizliegta.
Atveriet:
https://jusudomens.lv/robots.txt
un pārbaudiet noteikumus dažādiem user-agent.
OpenAI gadījumā, piemēram, iespējams atsevišķi kontrolēt OAI-SearchBot un GPTBot.
Ja vēlaties parādīties ChatGPT Search, bet nevēlaties atļaut training crawlerim:
User-agent: OAI-SearchBot
Allow: /
User-agent: GPTBot
Disallow: /
Svarīgi atcerēties:
robots.txt kontrole un JavaScript renderēšanas spēja ir divi dažādi jautājumi.
Robots var būt atļauts, bet nespēt izpildīt JavaScript.
Vai arī spēt renderēt lapu, bet būt bloķēts jau piekļuves līmenī.
Ceturtais tests: vai hostings, CDN vai WAF crawleri nelaiž iekšā?
robots.txt nav vienīgais bloķēšanas mehānisms.
Piekļuvi var ierobežot:
- Cloudflare;
- WAF;
- CDN;
- bot protection;
- rate limiting;
- JavaScript challenge;
- CAPTCHA;
- IP bloķēšana.
Cilvēka pārlūks var veiksmīgi izpildīt drošības pārbaudi.
Crawleris var saņemt:
403 Forbidden
vai:
429 Too Many Requests
un pie satura vispār nenonākt.
OpenAI savā dokumentācijā Search redzamībai iesaka ne tikai atļaut OAI-SearchBot robots.txt, bet arī nodrošināt, ka hostings un drošības infrastruktūra atļauj OpenAI publicēto SearchBot IP trafiku.
Tāpēc AI redzamības tehniskajā pārbaudē jāskatās ne tikai uz:
"Vai saturs ir HTML?"
bet arī:
"Vai crawleris līdz šim HTML vispār tiek?"
Piektais tests: servera un CDN logi
Servera vai CDN logi ļauj redzēt crawleru faktisko aktivitāti.
Var pārbaudīt, vai pieprasījumos parādās:
- Googlebot;
- OAI-SearchBot;
- GPTBot;
- ClaudeBot;
- PerplexityBot.
Logos iespējams redzēt:
- kurus URL robots pieprasa;
- cik bieži tas nāk;
- kādu HTTP statusu saņem;
- vai rodas 403;
- vai rodas 429;
- vai tas regulāri nonāk 404 lapās.
Taču ir viena svarīga drošības nianse.
Ar user-agent nosaukumu vien nepietiek, lai droši pierādītu, ka pieprasījumu tiešām veicis konkrētais serviss.
User-agent var tikt viltots.
Ja nepieciešama drošāka verifikācija, konkrētiem servisiem jāpārbauda arī:
- oficiāli publicētie IP diapazoni;
- servisa dokumentētais verifikācijas mehānisms;
- cita oficiālā botu identifikācijas informācija.
OpenAI, piemēram, publicē atsevišķus IP sarakstus OAI-SearchBot, GPTBot un ChatGPT-User.
Google ir svarīgs izņēmums
Googlebot JavaScript renderē.
Google JavaScript apstrādes procesu vienkāršoti var aprakstīt:
crawling → rendering → indexing
Google izmanto Chromium, lai renderētu JavaScript lapas.
Arī Google ģeneratīvās meklēšanas funkcijas nav pilnīgi atsevišķs "AI crawler SEO universs".
AI Mode un AI Overviews izmanto Google Search infrastruktūru, indeksu un kvalitātes sistēmas.
Tāpēc Google AI redzamībai joprojām ir svarīgi:
- lai lapa būtu pārmeklējama;
- lai tā būtu indeksējama;
- lai resurss nebūtu bloķēts;
- lai svarīgais saturs būtu pieejams;
- lai vietnes tehniskais SEO būtu sakārtots.
Tas nenozīmē, ka Google vienmēr perfekti apstrādās jebkuru JavaScript implementāciju.
Bet JavaScript klātbūtne pati par sevi nav Google SEO problēma.
Kāpēc server-side HTML ir drošs pamats?
Mērķis nav:
"nelietot JavaScript".
JavaScript ir normāla mūsdienu web izstrādes daļa.
Mērķis ir:
"nepadarīt būtisku publisko informāciju nevajadzīgi atkarīgu no klienta puses renderēšanas."
Ja serveris jau nosūta:
- lapas virsrakstu;
- galveno tekstu;
- saites;
- produkta datus;
- pakalpojuma informāciju;
tad JavaScript pēc tam var pievienot:
- interaktivitāti;
- filtrus;
- kalkulatorus;
- animācijas;
- lietotāja stāvokli;
- citus dinamiskus elementus.
Tas ir daudz noturīgāks modelis dažādu crawleru un aģentu vidē.
Vispirms biznesa prasība, pēc tam SSR, SSG vai ISR
Nav svarīgi sākt ar tehnoloģijas nosaukumu.
Svarīgi panākt, lai:
publiski nozīmīgais saturs jau servera atbildē būtu pieejams saprotamā HTML.
Tikai pēc tam izvēlas tehnisko pieeju.
Server-side rendering jeb SSR
Serveris ģenerē HTML pieprasījuma laikā.
Crawleris uzreiz saņem saturu dokumentā.
Static Site Generation jeb SSG
HTML tiek sagatavots iepriekš, piemēram, build laikā.
Tas labi der saturam, kas nav jāmaina katru sekundi.
Incremental Static Regeneration jeb ISR
Statiski ģenerētu lapu iespējams periodiski atjaunot, nepārbūvējot pilnīgi visu vietni.
Prerendering
Sistēma iepriekš sagatavo renderētu HTML versiju.
Konkrētā arhitektūra ir izstrādes jautājums.
Biznesa jautājums paliek tas pats:
ko crawleris saņem, pirms tam ir nepieciešams izpildīt klienta puses JavaScript?
Kā ar dynamic rendering?
Agrāk populāra pieeja bija dynamic rendering:
- lietotājam dod client-side JavaScript lapu;
- robotam speciāli ģenerē atsevišķu renderētu versiju.
Google šo pieeju šobrīd uzskata par workaround, nevis ieteicamu ilgtermiņa risinājumu.
Praktiski labāks pamats ir:
- server-side rendering;
- static rendering;
- hydration;
- cita arhitektūra, kur būtiskais saturs ir pieejams gan lietotājam, gan crawlerim.
Tas arī samazina situācijas, kur jāuztur divas tehniski atšķirīgas vienas lapas versijas.
Vai jāizveido īpaša HTML versija AI robotiem?
Parasti nē.
Nav laba ideja vienu saturu rādīt cilvēkam, bet būtiski atšķirīgu saturu robotam tikai ar mērķi manipulēt redzamību.
Labāks princips ir:
viena kvalitatīva informācijas versija, kas tehniski pieejama pēc iespējas plašākam sistēmu lokam.
Tas palīdz:
- cilvēkiem;
- Google;
- AI crawleriem;
- accessibility rīkiem;
- citiem automatizētiem klientiem.
Kurām vietnēm ir lielāks JavaScript/renderēšanas risks?
| Situācija | Satura pieejamības risks crawlerim bez JavaScript |
|---|---|
| Tradicionāla servera renderēta mājaslapa | Zemāks |
| WordPress saturs jau servera HTML | Parasti zemāks |
| SSR/SSG veidota React, Vue, Nuxt vai Next vietne | Parasti zemāks |
| SPA ar gandrīz tukšu sākotnējo HTML | Augstāks |
| Produktu dati ielādējas tikai pēc client-side API pieprasījuma | Augstāks |
| H1 un galvenais teksts tiek izveidots tikai JavaScript pusē | Augstāks |
| JavaScript izmantots galvenokārt interaktivitātei | Zemāks |
| CDN/WAF bloķē crawleri | Augsts neatkarīgi no renderēšanas |
Šī tabula nerāda kopējo AI redzamības iespēju.
Tā rāda tikai tehnisko satura pieejamības risku crawlerim, kas JavaScript neizpilda.
Server-side WordPress vietne var būt tehniski perfekti pieejama, bet joprojām netikt izmantota AI atbildēs, ja tās saturs nav pietiekami kvalitatīvs vai atbilstošs.
Ko vajadzētu būt iespējams nolasīt bez pilnīgas client-side renderēšanas?
Prioritāri:
Galveno lapas virsrakstu
H1 palīdz saprast lapas tēmu.
Galveno informatīvo saturu
Pakalpojuma definīcijai, produkta aprakstam vai svarīgākajām specifikācijām nevajadzētu pazust bez JavaScript.
Svarīgās iekšējās saites
Crawlerim jāspēj atklāt citas būtiskas lapas.
Canonical un robots norādes
Tām jābūt korekti implementētām.
Būtiskus produktu vai pakalpojumu datus
Ja cena, pieejamība vai specifikācija ir svarīga konkrētā satura izpratnei, jāvērtē, kā šo informāciju saņem dažādi klienti.
Tas nenozīmē, ka visi reāllaika dati obligāti jāieliek statiskā HTML.
Svarīgs ir nošķīrums:
pamatinformācija
pret
dinamiska lietotāja funkcionalitāte.
Ko mums deva Brandsite 25. oktobra audits?
Mūsu audita svarīgākais rezultāts šajā kontekstā nebija konkrēts Ahrefs skaitlis.
Tas bija jautājums, ko sākām pārbaudīt sistemātiski:
kādu Brandsite saturu saņem robots pirms JavaScript izpildes un kādu saturu cilvēks redz pēc pilnas renderēšanas?
Tas mainīja arī pašu audita domāšanu.
Nevis:
Ahrefs atrada JavaScript problēmu → salabojam JavaScript
bet:
rīks atklāj iespējamu tehnisku signālu → pārbaudām sākotnējo HTML → salīdzinām ar renderēto lapu → noskaidrojam iespējamo ietekmi → tikai tad lemjam par izmaiņām.
JavaScript klātbūtne pati par sevi nav kļūda.
Problēma ir tad, ja tehniskā implementācija rada nevajadzīgu barjeru informācijai, kuru vēlamies padarīt atrodamu.
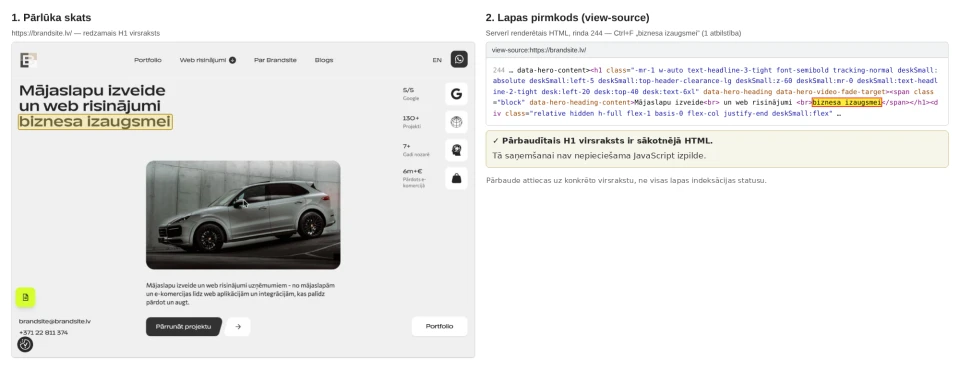
Mūsu tests: Brandsite sākumlapa
Pārbaudītais URL:
https://brandsite.lv/
Pārbaudītā frāze:
sākumlapas H1 virsraksts "Mājaslapu izveide un web risinājumi biznesa izaugsmei" (meklējām "biznesa izaugsmei")
Rezultāts View Source:
frāze ir sākotnējā HTML - tā atrodama servera renderētajā HTML (1 atbilstība).
Secinājums:
sākumlapas galvenais virsraksts ir pieejams jau servera atbildē, un tā saņemšanai nav nepieciešama JavaScript izpilde. Šī pārbaude attiecas uz konkrēto virsrakstu, nevis uz visas lapas indeksācijas statusu.
Kā tas saistās ar AI SEO?
AI SEO nav īpašs triks, ko var uzlikt virsū tehniski nepieejamai vietnei.
Redzamībai AI meklēšanas vidē joprojām nepieciešams:
tehniski pieejams saturs → skaidra struktūra → noderīga informācija → uzticami avoti
Tāpēc JavaScript renderēšana ir labs piemērs tam, kur:
klasiskais tehniskais SEO
un
AI discoverability
pārklājas.
Vai llms.txt atrisina JavaScript problēmu?
Nē.
llms.txt nepadara client-side renderētu saturu automātiski pieejamu crawlerim.
Google savās AI optimizācijas vadlīnijās norāda, ka Google Search ģeneratīvajām funkcijām llms.txt nav nepieciešams un tas pats par sevi neuzlabo vai nepasliktina redzamību Google.
Tas nenozīmē, ka citi servisi nekad nevar izmantot šādus failus.
Taču tas nav aizvietotājs tehniski pieejamam saturam.
Ja svarīgs teksts eksistē tikai pēc JavaScript izpildes, vispirms jārisina pati satura pieejamība.
Vai īpaša AI Schema.org shēma atrisinās problēmu?
Arī nē.
Nav īpašas AI SEO vai GEO Schema.org shēmas, kas būtu nepieciešama Google AI Mode vai AI Overviews.
Parastie strukturētie dati joprojām ir noderīgi tur, kur tie atbilst konkrētajam saturam.
Taču tiem nevajadzētu kļūt par aizvietotāju pašam saturam.
Pareizā secība ir:
pieejams saturs → korekta HTML struktūra → atbilstoši strukturētie dati
nevis otrādi.
Ko pārbaudīt AI redzamības tehniskajā auditā?
Ja mērķis ir saprast, vai mājaslapa ir tehniski gatava plašākai AI meklēšanas videi, pārbaude nebeidzas pie View Source.
1. Sākotnējais HTML
Vai svarīgais saturs tajā eksistē?
2. Renderētā lapa
Kas tiek pievienots tikai pēc JavaScript izpildes?
3. Google crawling un indexing
Vai Google lapu var korekti pārmeklēt un indeksēt?
4. AI crawleru piekļuve
Ko atļauj robots.txt?
5. CDN un WAF
Vai drošības infrastruktūra crawleri nelaiž iekšā?
6. HTTP statusi
Vai robots saņem:
- 200;
- 301;
- 403;
- 404;
- 429?
7. Iekšējās saites
Vai svarīgas lapas iespējams atklāt bez sarežģītas JavaScript interakcijas?
8. Satura struktūra
Vai būtiskā informācija ir skaidri atrodama?
9. Faktiskā AI redzamība
Vai uzņēmums, tā lapas un informācija tiek izmantota vai citēta AI meklēšanas vidē?
Šeit klasiskais tehniskais SEO pāriet plašākā AI discoverability izvērtējumā.
Biežāk uzdotie jautājumi
Vai AI aģenti tiešām nelasa JavaScript?
Ne visi.
Googlebot JavaScript renderē, un browser tipa AI aģenti var izmantot pilnvērtīgu pārlūkprogrammu.
Savukārt Vercel/MERJ 2024. gada decembra testos vairāki nozīmīgi AI crawleri JavaScript neizpildīja.
Tāpēc virsraksts raksturo reālu tehnisku risku, nevis universālu likumu par visiem AI aģentiem.
Vai ChatGPT lasa JavaScript?
Nav korekti visus OpenAI web piekļuves veidus saukt par vienu "ChatGPT crawler".
OpenAI izmanto OAI-SearchBot, GPTBot un ChatGPT-User dažādiem mērķiem.
2024. gada Vercel/MERJ testā OpenAI analizētie crawleri JavaScript neizpildīja.
Tomēr browser un lietotāja iniciēti scenāriji var darboties citādi, un infrastruktūra laika gaitā var mainīties.
Vai Google AI Overviews redz JavaScript saturu?
Google ģeneratīvās AI funkcijas balstās Google Search infrastruktūrā, un Googlebot JavaScript renderē.
Lapai joprojām jābūt pārmeklējamai, indeksējamai un tehniski korekti izveidotai.
Vai JavaScript ir slikts SEO?
Nē.
JavaScript ir normāla mūsdienu web tehnoloģija.
Risks rodas no konkrētās implementācijas, ja svarīgs publiskais saturs vai saites kļūst pieejamas tikai pēc klienta puses renderēšanas.
Vai WordPress vietnēm šī problēma ir mazāka?
Bieži jā, jo WordPress pamata saturs parasti tiek nosūtīts servera HTML.
Taču arī WordPress var izmantot spraudņus, widgetus vai ārējus risinājumus, kas saturu ielādē tikai ar JavaScript.
Tāpēc jāpārbauda konkrētā lapa, nevis jāpaļaujas uz CMS nosaukumu.
Vai Nuxt vai Next.js mājaslapu AI crawleri redz?
Tas atkarīgs no renderēšanas konfigurācijas.
Nuxt un Next.js var izmantot server-side rendering vai statisku ģenerēšanu, kur crawleris saņem pilnvērtīgu HTML.
Taču iespējams arī izveidot lapas, kur būtiska informācija tiek iegūta tikai klienta pusē.
Framework nosaukums pats par sevi neko negarantē.
Vai GPTBot jāatļauj, lai parādītos ChatGPT Search?
Nē.
ChatGPT Search vajadzībām OpenAI izmanto OAI-SearchBot.
GPTBot ir saistīts ar modeļu apmācības datu iegūšanu, un abus iespējams kontrolēt atsevišķi.
Vai llms.txt palīdz AI redzamībai?
Google Search ģeneratīvajām funkcijām tas nav nepieciešams.
Tas arī neatrisina client-side renderēšanas, robots.txt, WAF vai crawler piekļuves problēmas.
Kā ātri saprast, vai mājaslapai ir renderēšanas risks?
Desktop pārlūkā:
- izvēlieties svarīgu lapu;
- nokopējiet unikālu satura teikumu;
- atveriet View Source;
- meklējiet šo teikumu.
Ja pārlūkā tas ir redzams, bet sākotnējā HTML nav atrodams, ir pamats veikt padziļinātu renderēšanas pārbaudi.
Tas vēl nav pierādījums, ka konkrēts AI serviss lapu neredz.
Kopsavilkums
Lielākā kļūda ir pieņemt, ka tas, ko cilvēks redz pārlūkā, automātiski ir tas pats, ko saņem katrs meklēšanas vai AI robots.
Dažas sistēmas JavaScript renderē.
Citas konkrētos testos to nav darījušas.
Browser aģenti var izmantot pilnvērtīgu pārlūkprogrammu.
Crawleri var strādāt galvenokārt ar servera atbildi.
Tāpēc ilgtspējīgs princips ir:
svarīgākajam publiskajam saturam jābūt tehniski pieejamam pēc iespējas plašākam sistēmu lokam.
Brandsite 25. oktobra SEO audits tieši šo jautājumu lika pārbaudīt padziļināti:
ne tikai "vai lapa strādā pārlūkā?", bet "kādu informāciju no tās saņem dažādas sistēmas?".
Un tieši tur sākas atšķirība starp vienkāršu tehnisko checklist un mūsdienīgu SEO / AI discoverability auditu.